压缩域图像深度学习分类/分割论文调研
为什么要做压缩域图像深度学习分类/分割?
互联网上充斥着大量图像,它们基本都是以压缩的形式存在。在传统的训练过程中,需要将图像数据从压缩域(Compressed Domain)解压到像素域(Pixel Domain),再输入到网络中进行训练。然而,解压这一步真的有意义吗?解压只是将数据形式进行转换,而数据所表达的信息却没有发生任何变化。因此,从理论上来说,可以跳过解压步骤,直接将压缩域输入到网络中训练和推理,只要网络设计得当,精度不会差于像素域,甚至还可能会更好。 跳过解压缩步骤的最大好处是可以提升训练和推理的速度,假设一张图片解压所需要的时间是0.1s,那么训练一轮ImageNet(2500万张图片)所节省的时间约为417h,对于当今大训练数据的今天,还是非常可观的。 当前最流行的压缩算法是JPEG,它主要分为以下个步骤:
- 分块: JPEG压缩过程首先将图像分割成8x8像素的小块。
- 离散余弦变换(DCT):然后对每个小块进行离散余弦变换。DCT将图像从空间域转换到频率域,将图像的像素值转换为频率系数。
- 量化:DCT转换后的频率系数通过量化过程进一步压缩。量化是一种将连续的频率系数映射到有限数量的离散值的方法。由于人眼对高频细节不太敏感,可以对高频系数进行更大幅度的量化,从而减少数据量。
- 熵编码:量化后的系数通过熵编码进一步压缩。熵编码是一种无损压缩技术,它根据数据的概率分布来优化编码长度。常用的熵编码方法包括霍夫曼编码和算术编码。
解压过程为压缩的逆过程。
因为其中最关键的步骤是2离散余弦变换,也是在解压中最耗时的步骤,所以本文讨论的压缩域指的就是其中第2步中的DCT域。 下面通过三篇代表工作介绍最新的方法。
DCT压缩域+CNN
《Deep Residual Learning in the JPEG Transform Domain》
ICCV 2019
作者是Max Ehrlich和Larry Davis,来自马里兰大学帕克分校。
论文主要介绍了一种在JPEG变换域中进行残差网络(Residual Network)推理和学习的方法。这种方法允许网络直接以压缩图像作为输入,从而避免了昂贵的解压缩步骤,提高了处理速度,同时对网络准确性的影响很小。这篇文章的理论性很高,实验效果也非常好。 以下是对论文内容的详细解读:
- 引言 背景:深度学习自2012年AlexNet架构以来取得了巨大进步,但深度网络需要大量数据和计算资源,这对于许多研究者来说是一个挑战。 问题:传统的机器学习在使用JPEG图像时,首先需要解压缩它们。作者提出跳过这一步骤,直接在压缩图像上进行操作。 目标:通过将压缩变换纳入网络权重,创建一个新的网络,使其在数学上与空间域网络等价,但操作的是压缩图像。
- 相关工作 压缩域操作:在80年代末和90年代初,研究者们开发了在压缩域中执行常见操作的方法。 压缩域机器学习:90年代中期,研究者们开始在压缩域中进行图像处理和检索。 压缩域深度学习:由于深度网络是非线性映射,压缩域中的深度学习研究有限。
- 背景知识 JPEG压缩:JPEG压缩算法包括将图像分成8×8块,计算每个块的二维离散余弦变换(DCT),量化,然后进行编码。 JPEG线性映射:JPEG压缩的前四个步骤是线性映射,可以组合成单一的线性映射,直接在压缩表示上执行操作。
- JPEG域残差网络 卷积:通过线性映射实现卷积操作,避免了显式计算空间域映射的开销。 ReLU:由于ReLU是非线性函数,作者开发了一种称为近似空间掩模(Approximated Spatial Masking, ASM)的技术来近似ReLU。 批量归一化:在JPEG域中,批量归一化有简单且高效的实现。 逐分量加法:由于JPEG变换是线性的,逐分量加法可以直接在压缩结果上执行。 全局平均池化:在JPEG域中,全局平均池化可以通过直接读取每个块的0th元素(即块的平均值)来实现。 模型转换:可以将预训练的空间域网络转换为JPEG域网络,以便在推理时使用。
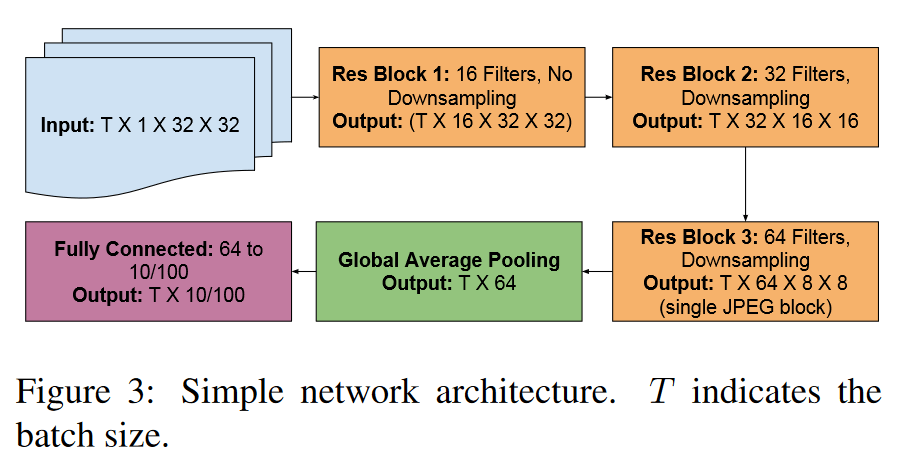
- 实验 网络架构和数据集:使用MNIST和CIFAR-10/100数据集,网络架构包括三个残差块,最终输出一个单一的JPEG块。 模型转换:通过模型转换,证明了JPEG模型与空间域模型在数学上等价。 ReLU近似精度:研究了ReLU近似对网络性能的影响,发现ASM方法比直接近似方法更准确。 训练和测试效率:实验表明,JPEG模型在推理时的性能显著优于空间模型,但在训练时由于梯度复杂度较高,性能提升有限。
- 结论与未来工作 结论:展示了在JPEG变换域中进行深度残差学习的方法,并证明了其在处理时间上的优势。 未来工作:需要关注表示效率和深度学习库对所需特征的支持。
DCT压缩域+Transformer
《Compressed-Domain Vision Transformer for Image Classification》
IEEE JOURNAL ON EMERGING AND SELECTED TOPICS IN CIRCUITS AND SYSTEMS(2区) 2024
作者Ruolei Ji:亚利桑那州立大学电气、计算机和能源工程学院的博士生。
摘要: 文章提出了一种在压缩域中直接进行图像分类的方法,称为压缩域视觉变换器(Compressed-Domain Vision Transformer,简称cViT)。这种方法利用基于学习的压缩域图像表示(也称为潜在表示)来执行图像分类,而不需要对压缩的视觉信息进行解码。研究表明,与相应的空间域视觉任务相比,这种方法在训练和部署过程中能够实现更高的计算效率,并且在某些情况下,性能甚至更为优越。
主要内容:
- 引言:介绍了基于学习的方法(如卷积神经网络CNNs、循环神经网络RNNs和变换器)如何集成到图像/视频压缩方法中,并讨论了传统压缩方法与基于学习的压缩方法的不同之处。
- 相关工作:回顾了在压缩域视觉模型训练方面的研究进展,包括基于CNN的模型在量化潜在表示上的应用,以及如何通过训练学习型压缩模型和分类模型来提高图像质量和分类准确性。
- 提出的框架:详细介绍了cViT的架构,包括特征块嵌入、高维映射和压缩域位置嵌入的创新设计,以及如何利用预训练的空间域ViT权重来初始化位置嵌入。
- 背景:介绍了基于学习的图像压缩模型和视觉变换器(ViT)的背景知识。
- 实验结果:展示了cViT在ImageNet数据集上的性能,并与其他压缩域分类方法以及像素域方法进行了比较。
- 结论:总结了cViT的主要贡献和优势,并指出了未来可能的研究方向。
结论要点:
- cViT在压缩域中直接进行图像分类,减少了训练复杂性。
- 与传统的像素域分类方法相比,cViT在保持Top-1和Top-5准确率竞争力的同时,实现了更高的计算效率。
- cViT避免了基于学习的压缩方法中耗时/计算复杂的解码过程。
深度学习压缩域+CNN
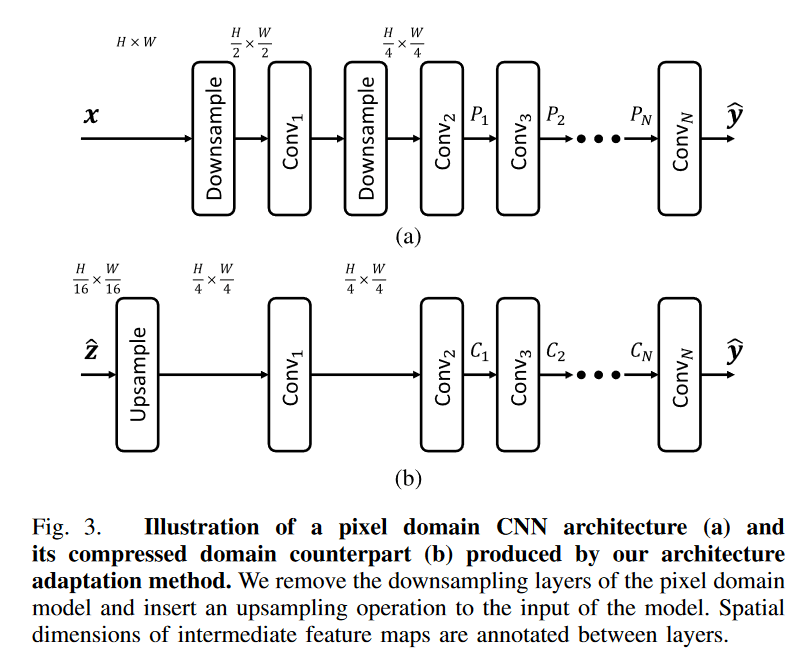
《Unified Architecture Adaptation for Compressed Domain Semantic Inference》
IEEE Transactions on Circuits and Systems for Video Technology 2023
作者是Zhihao Duan、Zhan Ma和Fengqing Zhu,他们分别是IEEE的学生会员、高级会员和高级会员。
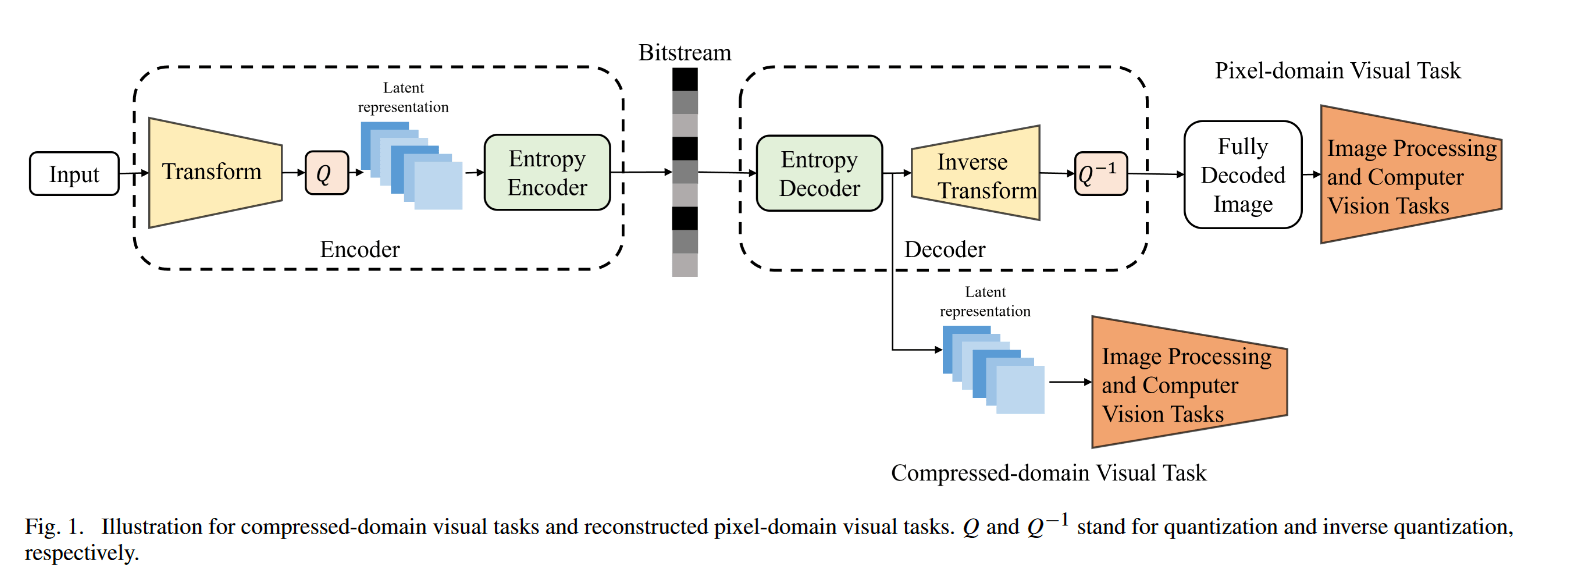
摘要: 文章讨论了深度学习技术在有损图像压缩和语义内容理解方面的进展,指出尽管这两个任务在过去几十年中分别发展,但本文提出了一种直接从深度压缩域中的量化潜在特征执行语义推断的方法,而无需像素重建。作者提出了一种轻量级、即插即用(plug-and-play)的解决方案,与流行的学习型图像编码器和深度视觉模型兼容,适用于广泛的应用。该方法将现有的像素域神经模型调整为直接接受量化潜在特征,并通过从对应的像素域模型转移知识来训练压缩域模型。实验表明,该方法与流行的学习型图像编码器和视觉任务模型兼容,在公平比较下,与基线方法相比,在压缩域分类的top-1准确率上提高了3%以上,在压缩域语义分割的mIoU上提高了7%以上。
引言: 文章开头引用了“一幅图胜过千言万语”的说法,强调图像中包含的信息量巨大,通常需要有损压缩以便于在带宽受限的网络中传输。同时,图像中包含的信息提供了图像内容理解和决策的语义含义。然而,图像压缩和图像内容理解任务在过去几十年中是分开发展的。
相关工作: 文章回顾了学习型有损图像编码(LIC)的研究进展,以及视频编码为机器(VCM)的概念,这与本文的研究问题相关。此外,还讨论了压缩域机器视觉和知识转移的相关工作。
问题阐述: 文章详细描述了学习型图像编码器的流程,包括自动编码器框架和率失真优化,并定义了压缩域语义推断的问题。
方法: 文章介绍了如何从像素域视觉模型转移知识以改进压缩域模型的性能。首先提出了一种像素到压缩域的知识转移策略,然后介绍了一种简单高效的像素域模型架构调整方法,以便执行压缩域任务。
实验: 文章通过一系列实验评估了所提出的方法在压缩域图像分类和语义分割方面的性能。使用了ImageNet数据集进行训练和测试,并展示了不同学习型图像编码器和不同像素域架构的性能比较。
结论: 文章总结了通过直接使用深度压缩图像的潜在特征进行压缩域视觉任务的方法。与现有方法不同,该方法通过简单的网络架构修改和从相应的像素域模型转移知识,提高了性能。实验结果表明,所提出的方法在压缩域分类和语义分割方面优于现有基线方法。
**点评:**这篇文章直接抛弃了JPEG,自己提出了一套自编码器框架,通过编码器提取的特征既能做压缩,又能做深度学习分类/分割任务。其实我也有过类似的idea,但是我觉得这个事情意义不大,因为基于深度学习的图像压缩目前仍然处于非常初步的理论阶段,不具有落地价值。这篇文章能够发表,主要是因为作者包装得好,而不是因为它真的很有用。