Vane Agent 搜索流程分析:Speed 与 Balanced 模式
这篇文档不按代码文件逐项罗列,而是从算法与 Agent 工程设计角度解释 Vane 的搜索问答系统。目标读者可以完全不阅读代码,只通过本文理解系统如何从一个用户问题演进到一个带来源、带中间过程、可流式输出的回答,并能够复刻一个相似的 Agent 搜索算法。
本文重点讨论 Speed 与 Balanced 两个模式。Quality 只在必要时作为对照出现。
1. 这个系统到底在做什么
Vane 的搜索能力不是“把用户问题直接丢给搜索引擎,再把结果拼给模型”。它更接近一个轻量级 Deep Research Agent:
- 先让一个 LLM 判断用户问题属于什么类型。
- 同时决定是否需要外部搜索、是否需要天气/股票/计算等专用组件。
- 如果需要搜索,启动一个 Researcher Agent。
- Researcher Agent 在若干轮循环中自己决定调用哪些工具、用哪些 query、何时结束。
- 搜索结果被整理成上下文。
- 最后由 Writer LLM 根据这些上下文生成最终回答。
可以把它看成一个两阶段 Agent:
阶段 A:研究阶段 Research
  用户问题
    -> LLM 分类与问题改写
    -> Widget 并行计算结构化结果
    -> Researcher Agent 多轮调用搜索/阅读/上传文件检索等工具
    -> 得到 search findings 与 widget findings

阶段 B:写作阶段 Write
  用户问题 + 历史对话 + search findings + widget findings
    -> Writer LLM
    -> 流式生成最终回答
其中 Speed 和 Balanced 的区别主要不在底层搜索引擎,而在阶段 A 的 Researcher Agent 如何行动:
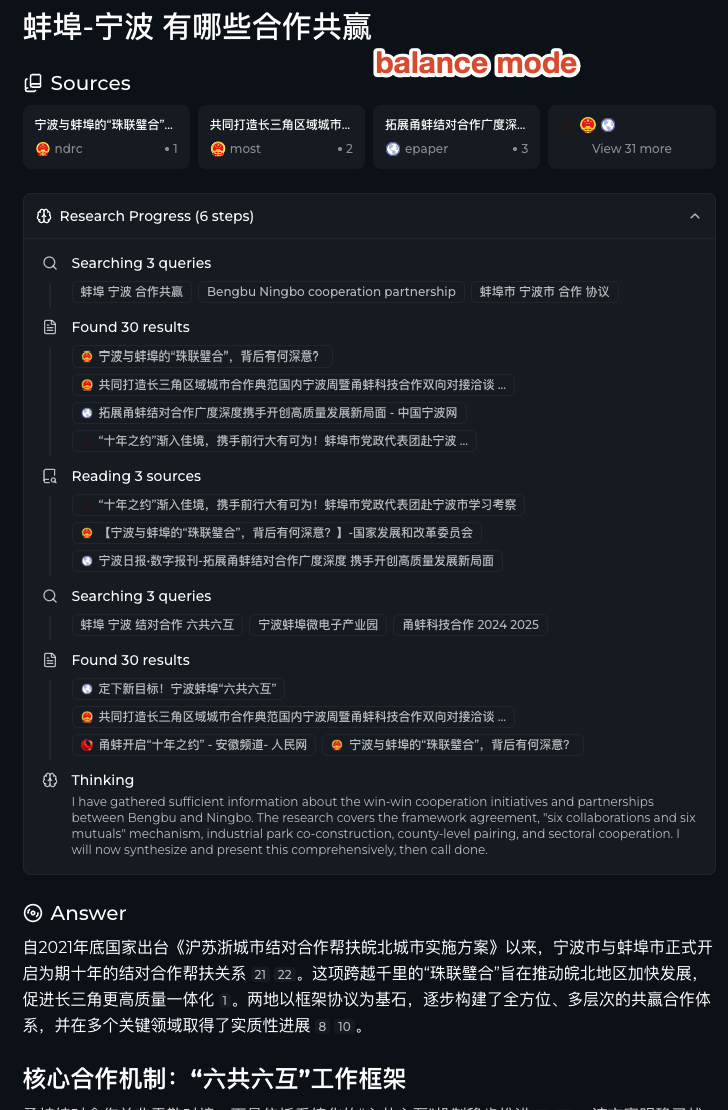
Speed:少轮次、少解释、尽快拿到够用信息。Balanced:更多轮次、带简短 reasoning、允许根据已有结果继续搜索。
2. 关键概念:这些名字在本项目中分别是什么意思
2.1 Classifier:不是传统深度学习分类器,而是 LLM 路由器
项目里的 Classifier 不是一个单独训练的深度学习分类模型,也不是 sklearn 那种分类器。它本质上是一次 LLM 结构化输出调用。
它接收:
- 历史对话
- 当前用户问题
- 一段分类说明 prompt
- 一个 JSON schema
然后让 LLM 输出类似这样的结构:
{
  "classification": {
    "skipSearch": false,
    "personalSearch": false,
    "academicSearch": false,
    "discussionSearch": false,
    "showWeatherWidget": false,
    "showStockWidget": false,
    "showCalculationWidget": false
  },
  "standaloneFollowUp": "自包含的问题改写"
}
它承担两个任务。
第一,做路由判断:
skipSearch:是否不需要搜索。personalSearch:是否需要查用户上传文件。academicSearch:是否需要学术搜索。discussionSearch:是否需要社区/讨论搜索。showWeatherWidget:是否需要天气组件。showStockWidget:是否需要股票组件。showCalculationWidget:是否需要计算组件。
第二,做问题改写:
- 把多轮对话里的 follow-up 改写成一个脱离上下文也能理解的问题。
- 例如前文在聊“特斯拉”,用户问“它最近怎么样”,Classifier 应该改写为“特斯拉最近发展情况如何”。
因此,Classifier 更准确的名字应该是:LLM Query Router + Standalone Question Rewriter。
2.2 Widget:专用结构化能力,不是 Researcher 的工具
Widget 是项目里给某些垂直任务准备的专用执行器,比如:
- 天气 Widget
- 股票 Widget
- 计算 Widget
Widget 和 Researcher 工具不是同一层东西。
Researcher 工具是 Agent 在循环中主动选择调用的工具。Widget 则是在 Classifier 判断后由系统并行触发的结构化组件。它不参与 Researcher 的多轮思考,也不由 Researcher 决定是否调用。
更准确地说:
Classifier 先判断是否需要 Widget
  -> WidgetExecutor 根据 classification 并行执行对应 Widget
  -> Widget 结果一方面展示给用户,另一方面作为上下文交给 Writer
所以不是“Widget 用 classify 判断然后再调用 Researcher”。真实关系是:
Classifier
  ├─ 决定哪些 Widget 应该跑
  └─ 决定 Researcher 是否应该跑,以及哪些搜索工具可用

WidgetExecutor 和 Researcher 是并行分支
  ├─ WidgetExecutor:处理天气、股票、计算等结构化任务
  └─ Researcher:处理开放式搜索与资料收集
Widget 的输出有两个用途:
- UI 上显示一个结构化卡片或结果块。
- 写作阶段作为
widgets_result注入上下文,让最终回答可以使用这些信息。
但是系统 prompt 里明确区分了搜索来源和 Widget 结果:搜索结果可以 citation,Widget 结果可以使用但不作为引用来源。
2.3 Researcher:真正的搜索 Agent
Researcher 是本文最核心的概念。它是一个会循环调用工具的 Agent。
它不是直接回答用户,而是负责“收集足够的信息”。它的输出不是自然语言答案,而是一组 findings:搜索结果、阅读结果、上传文件检索结果等。
Researcher 的基本循环是:
初始化可用工具
初始化研究上下文
for i in 最大迭代次数:
    构造 researcher system prompt
    把历史工具调用与工具结果发给 LLM
    LLM 以 tool calling 形式选择下一步动作
    如果没有工具调用:停止
    如果 LLM 认为 done:停止
    执行工具
    把工具结果写回 Agent 消息历史
汇总搜索结果
按来源去重
交给 Writer
它类似一个 ReAct Agent,但它没有把“Thought/Action/Observation”写成纯文本模板,而是主要依赖模型原生 tool calling:
- LLM 通过工具调用决定 action。
- 工具结果以 tool message 形式回传。
- 下一轮 LLM 看到之前的 tool results,再决定下一步。
Balanced 模式里额外暴露了 __reasoning_preamble 工具,用来让模型在真实工具调用前输出简短计划。这会让 Researcher 的中间过程更可解释。
2.4 Writer:不是 Agent 循环,只负责最终答案生成
Writer 是研究完成后的回答生成器。
它不再调用工具,也不再搜索。它拿到:
- 用户问题
- 对话历史
- Researcher 收集的 search results
- Widget 产生的 structured results
- 用户自定义 system instructions
然后流式写出最终回答。
因此逻辑顺序上应该先理解 Researcher,再理解 Writer。Writer 是 Researcher 的消费者,不是 Researcher 的一部分。
3. 模型与工具调用:底层库、Provider、原生工具调用还是 prompt 手搓
3.1 项目自己封装了一层模型抽象
Vane 没有直接在业务代码里到处调用某一个模型 SDK,而是定义了一个统一的 BaseLLM 抽象。这个抽象暴露四类能力:
generateText     -> 普通文本生成
streamText       -> 流式文本/工具调用生成
generateObject   -> 结构化 JSON 生成
streamObject     -> 流式结构化 JSON 生成
业务层只依赖这个抽象,而不直接依赖 OpenAI、Anthropic、Gemini 等具体 SDK。
3.2 Provider 是项目自己写的适配层
Provider 不是直接把 LangChain / Vercel AI SDK 作为 Agent 框架使用。项目更像是自己写了一套轻量 provider adapter:
- 每个 provider 负责加载 chat model 和 embedding model。
- 上层 Agent 只拿到统一的
BaseLLM和BaseEmbedding。 - Agent loop、工具注册、工具执行、状态管理都是项目自己实现的。
也就是说,它不是使用 LangChain Agent、LlamaIndex Agent 这类高层框架,而是自己实现了 Agent 编排。
3.3 工具调用主要依赖模型原生 tool/function calling
以 OpenAI 风格实现为例,系统会把每个工具转换成 OpenAI Chat Completions 的 tools 参数:
工具名 name
工具描述 description
工具参数 JSON schema
  -> 转成 OpenAI function tool
  -> 传给 chat.completions.create({ tools, stream: true })
模型返回的也是原生 tool call delta,而不是在自然语言里输出一段伪 JSON 再由系统正则解析。
流式时,系统会累积 tool call arguments,并用 partial-json 解析不完整的 JSON 参数。等一轮模型流结束后,Researcher 获得完整 tool calls,再执行对应工具。
所以结论是:
- 工具选择与参数生成:主要依赖模型原生 tool/function calling。
- 工具说明:仍然有大量 prompt 工程,用自然语言告诉模型何时调用、如何调用、调用几次。
- 工具执行:项目自己实现。
- Agent loop:项目自己实现。
3.4 为什么还需要 prompt 里的工具描述
虽然有原生 tools schema,但项目仍然把工具说明拼进 researcher system prompt。这不是“手搓工具调用模板”,而是为了增强策略控制。
原生 tool schema 只能告诉模型:
这个工具叫什么
参数是什么结构
工具大概做什么
但它不擅长表达复杂策略,例如:
- Speed 模式 web_search 只调用一次。
- Balanced 模式先 broad query,再 narrow query。
- Balanced 每次工具前必须先输出 reasoning preamble。
- 到达工具调用上限后应该 done。
这些策略通过 system prompt 约束,而实际工具调用仍走原生 tool calling。
4. 从用户问题到研究任务:系统如何决定要不要搜索
整个算法的第一步是把用户问题变成“研究计划的输入”。
假设用户问:
最近 Kimi K2 有什么特点?和 GPT-5.1 比怎么样?
Classifier 会判断:
- 这是一个需要当前信息的问题,所以
skipSearch = false。 - 不是天气、股票、计算,所以对应 Widget 为 false。
- 如果开启了 web source,Researcher 应该可以使用 web_search。
- 问题本身已经比较完整,standaloneFollowUp 可能接近原问题。
如果用户问:
帮我算一下 25% of 80
Classifier 可能会判断:
showCalculationWidget = trueskipSearch = true
此时 Researcher 可能不启动,Widget 直接计算,Writer 根据 widget result 给出回答。
如果用户问:
这篇我上传的 PDF 主要讲什么?
Classifier 会倾向:
personalSearch = true- 如果有上传文件,Researcher 可使用
uploads_search
这一步是整个系统的路由层。它决定接下来是:
- 不搜索,直接写。
- 跑 Widget。
- 跑 Researcher。
- Widget 与 Researcher 并行跑。
5. Researcher Agent 循环:搜索智能的核心
5.1 Researcher 的输入
Researcher 拿到的输入包括:
- 最近若干轮对话历史。
- 用户当前问题。
- Classifier 的输出。
- 当前模式:Speed / Balanced / Quality。
- 可用搜索来源。
- LLM 与 embedding model。
- 上传文件 ID。
Researcher 不直接使用全部历史,而是截断到最近 10 轮。这是一个简单的上下文控制策略,用来避免历史对话无限增长。
5.2 Researcher 的可用工具不是固定全开
Researcher 启动时会根据 classification 和用户启用的 source 动态筛工具。
工具注册表中存在这些工具:
| 工具 | 作用 | 何时可用 |
|---|---|---|
web_search |
通用网页搜索 | 用户启用 web source,且 classifier 没有 skipSearch |
academic_search |
学术搜索 | 用户启用 academic source,且 classifier 判断需要 academicSearch |
social_search |
社区/讨论搜索 | 用户启用 discussions source,且 classifier 判断需要 discussionSearch |
uploads_search |
用户上传文件检索 | 存在上传文件,尤其是 classifier 判断 personalSearch 时 |
scrape_url |
抓取并阅读指定 URL | 始终注册,但 prompt 要求只有用户明确要求某 URL 时才调用 |
__reasoning_preamble |
生成简短研究计划/意图 | Balanced 和 Quality 可用,Speed 不可用 |
done |
告诉系统研究完成 | 始终可用 |
这里需要特别说明 scrape_url:
它是项目里的“阅读网页”工具。它并不是 web_search 自动返回全文后的阅读步骤,而是一个独立工具。它用于用户明确要求总结某个 URL,或者要求根据某个网页回答时。工具会抓取 URL 内容,如果内容太长,会切 chunk,再用 LLM 抽取相关事实。
而普通 web_search 在 Speed/Balanced 下默认只使用搜索引擎返回的标题与摘要内容,并不会自动逐个打开网页阅读全文。这一点很重要:
web_search:搜索 + 摘要结果 rerank。scrape_url:打开指定网页 + 抽取正文事实。
Quality 模式中底层搜索分支会更主动地挑选搜索结果并 scrape,但 Speed/Balanced 不是这样。
5.3 一轮 Researcher 是怎么工作的
每轮 Researcher 都会生成一个新的 system prompt,其中包含:
- 当前是第几轮。
- 最大迭代轮数。
- 当前模式的行为约束。
- 当前可用工具的自然语言描述。
- 如果有上传文件,还会包含文件摘要信息。
然后把这个 prompt、用户问题、历史工具调用、历史工具结果一起发给 LLM。
LLM 不应该直接回答用户,而应该选择工具。例如在 Speed 模式中可能输出:
web_search({ queries: ["Kimi K2 features", "Kimi K2 benchmark", "Kimi K2 vs GPT-5.1"] })
在 Balanced 模式中则更像:
__reasoning_preamble({ plan: "我先查找 Kimi K2 的核心能力和近期资料,再对比 GPT-5.1 的公开特性。" })
web_search({ queries: ["Kimi K2 features", "Kimi K2 benchmark", "GPT-5.1 features"] })
工具执行完成后,系统把结果作为 tool message 写回 Researcher 的上下文。下一轮 LLM 就能看到上轮搜索结果,并决定是否继续搜索、换 query、查学术源、查讨论源、读上传文件,或者 done。
这就是 Vane 的 Agent 搜索循环。
6. Speed 模式:压缩研究预算,追求快速可用答案
Speed 模式的设计目标是:尽快得到足够回答的信息,而不是穷尽资料。
它有几个核心约束。
6.1 迭代次数少
Speed 的 Researcher 最大迭代轮数是 2。
这通常意味着:
- 第一轮调用搜索工具。
- 第二轮看到搜索结果后调用 done,或者进行极少量补充。
如果问题简单,甚至第一轮就可能搜索后结束。
6.2 不暴露 reasoning 工具
Speed 模式不会启用 __reasoning_preamble。
这意味着模型不会专门输出“我下一步要做什么”的中间 reasoning block。系统也不会在 UI 上展示这类计划。
算法上的含义是:
- 减少一次额外工具调用。
- 减少 token 消耗。
- 减少中间状态展示成本。
- 让模型直接行动。
6.3 web_search 被提示为“一次性高密度搜索”
Speed 的 web_search 工具描述会告诉模型:
- 你大概率只有一次调用机会。
- 一次最多可以放 3 个 query。
- query 要具体,不要宽泛。
- 尽量一次覆盖核心信息面。
所以 Speed 的搜索策略不是逐步探索,而是一次性把最重要的 query 打出去。
例如:
用户:介绍一下某个新模型 X 的能力
Speed query 可能是:
  - "X AI model features"
  - "X AI model benchmark"
  - "X AI model release"
这是一种“shotgun but targeted”的策略:query 数不多,但覆盖定义、能力、发布时间或对比这些关键维度。
7. Balanced 模式:引入短推理和多轮收敛
Balanced 模式不是简单地把 Speed 跑慢一点。它引入了两个重要机制:
- 更多轮次。
- 显式 reasoning preamble。
7.1 迭代预算更大
Balanced 的最大迭代轮数是 6。
这允许它采用更像研究员的流程:
第一轮:宽泛搜索,建立主题概览
第二轮:根据结果发现重点,收窄 query
第三轮:补充对比、争议、近期变化或细分角度
后续轮:必要时调用 done 或继续补充
当然,Balanced prompt 仍要求克制,不鼓励无意义地搜索到上限。
7.2 强制 reasoning preamble
Balanced 模式会暴露 __reasoning_preamble 工具,并在 prompt 中要求:每次真实工具调用前先调用它。
这相当于把 ReAct 中的 Thought 显式工具化:
Thought -> __reasoning_preamble
Action  -> web_search / academic_search / uploads_search / ...
Observation -> tool result
但它和传统 ReAct 文本模板不同,因为 Thought 也是一个 tool call,能被系统结构化捕获并流式展示。
这个设计带来两个效果:
- 对用户:可以看到 Agent 为什么下一步这么查。
- 对模型:强迫它在行动前先压缩出一个短计划,降低盲目搜索概率。
7.3 web_search 策略变成“先广后窄”
Balanced 的 web_search 描述鼓励:
- 先用较宽 query 获取整体认识。
- 再根据结果中的新实体、新时间点、新争议点收窄 query。
- 不要一次搜索后立刻结束,除非问题很简单或信息已经足够。
因此 Balanced 能够处理更复杂的问题,例如:
用户:Kimi K2 最近有什么能力?和 GPT-5.1、Claude 相比如何?

Balanced 可能的演进:
1. 搜索 Kimi K2 features / release / benchmark
2. 发现关键词 mixture-of-experts、coding benchmark、agentic capability
3. 搜索 Kimi K2 vs GPT / Kimi K2 benchmark analysis / user reviews
4. 如果用户关心实际使用,再搜索 discussions 或评价
5. done
这就是 Balanced 相比 Speed 的主要价值:它不只依赖第一批搜索结果,而是允许结果驱动下一步 query reformulation。
8. web_search 为什么用 embedding
直觉上,web_search 工具应该就是调用搜索引擎。但 Vane 的 Speed/Balanced 搜索工具内部多做了一步 embedding rerank。
具体流程是:
输入:queries,最多 3 个

对每个 query:
  1. 调用 SearXNG 获取搜索结果
  2. 取每条结果的 title/content snippet
  3. 计算 query embedding
  4. 计算每条 result snippet 的 embedding
  5. 计算 query 与 result 的 cosine similarity
  6. 过滤掉相似度较低的结果

合并所有 query 的结果:
  7. 按 similarity 排序
  8. 用 result embedding 做语义去重
  9. 返回 top 20
也就是说,这里的 embedding 不是为了生成答案,也不是为了向量数据库检索网页全文,而是为了对搜索引擎返回的候选结果做轻量语义重排和去重。
它解决的问题是:搜索引擎返回的 top results 不一定都与用户 query 语义贴合,尤其是多个 query 并行搜索时,结果会混杂、重复、质量不均。Embedding rerank 相当于在搜索引擎之后加了一个语义过滤器。
可以把 web_search 理解为:
Search Engine Recall
  -> Embedding Semantic Filter
  -> Deduplication
  -> Compact Evidence Set
在 Speed/Balanced 下,系统没有打开每个网页阅读全文,所以这个 embedding rerank 的对象主要是搜索结果摘要,而不是完整网页正文。
9. 具体工具列表与各自算法角色
9.1 web_search
角色:通用网页检索工具。
输入:最多 3 个 query。
内部:SearXNG 搜索、embedding rerank、语义去重、返回最多 20 条结果。
主要用于回答需要外部当前信息的问题。
9.2 academic_search
角色:学术源检索工具。
它和 web_search 复用同一套底层 executeSearch 算法,但搜索引擎配置换成学术相关源,例如 arXiv、Google Scholar、PubMed。
启用条件更严格:用户启用了 academic source,并且 Classifier 判断问题确实需要学术资料。
9.3 social_search
角色:社区、讨论、评论类检索工具。
它同样复用 executeSearch,但搜索源偏向 Reddit 这类讨论平台。
适合用户问:
- “大家怎么看?”
- “用户反馈如何?”
- “常见问题有哪些?”
- “实际体验怎么样?”
9.4 uploads_search
角色:用户上传文件检索工具。
它不是查互联网,而是在用户上传的文档中检索。这里 embedding 的用途更接近传统 RAG:
用户 query
  -> query embedding
  -> 上传文件 chunks 向量检索
  -> 返回相关片段
它最多接收 3 个 query,返回上传文件中最相关的若干 chunk,并做简单去重合并。
9.5 scrape_url
角色:阅读指定网页正文。
这是用户提到“它可以阅读”的关键工具。它不是普通 web_search 的默认后处理,而是独立工具。
它做的事是:
输入 URL 列表,最多 3 个
  -> 抓取网页正文
  -> 如果正文过长,切成 chunk
  -> 对每个 chunk 用 LLM 抽取事实
  -> 合并抽取结果
  -> 返回 search_results 类型结果
Prompt 明确要求模型不要随便调用它,除非用户明确要求阅读某个 URL 或根据某个 URL 回答。这样可以控制成本,因为网页抓取和 LLM 抽取都比搜索摘要贵。
9.6 __reasoning_preamble
角色:结构化 Thought。
只在 Balanced / Quality 中启用。它让模型在每次真实动作前先生成一段简短计划。这个计划会作为研究过程的一部分展示,也会成为当前 Agent turn 的结构化输出。
9.7 done
角色:研究完成信号。
它不返回信息,只告诉外层循环:Researcher 认为资料已经足够,可以进入 Writer 阶段。
10. Writer:从 evidence 到 answer
Researcher 完成后,系统会把 findings 整理成 Writer 的上下文。
上下文大致分两类:
-
search_results- 来自 Researcher 的工具结果。
- 可以作为引用来源。
-
widgets_result- 来自天气、股票、计算等 Widget。
- 可以用于回答,但不作为 citation。
Writer 收到这些上下文后,不再调用工具,只负责生成最终回答。
10.1 引用标记是怎么生成的
回答里看到的 [1]、[2] 这类引用标记,不是搜索引擎直接返回的,也不是前端凭空猜出来的,而是 Researcher、Writer prompt 和前端渲染约定共同完成的编号协议。
整个机制可以理解成四步。
第一,Researcher 完成研究后,会把所有搜索类工具返回的 search_results 汇总起来。系统会按 URL 做一次去重:如果多个工具结果指向同一个 URL,就合并它们的内容;如果 URL 不同,就保留为独立来源。去重后的结果会形成一个有顺序的来源数组:
sources[0] -> 第 1 个来源
sources[1] -> 第 2 个来源
sources[2] -> 第 3 个来源
...
这个数组一方面会作为 source block 发给前端,用来展示 Sources 列表;另一方面会作为 Writer 的搜索证据。
第二,进入 Writer 之前,系统会把这些来源序列化成带编号的上下文:
<search_results note="These are the search results and assistant can cite these">
  <result index=1 title="...">...</result>
  <result index=2 title="...">...</result>
  <result index=3 title="...">...</result>
</search_results>
这里的 index=1、index=2 就是最终回答中 [1]、[2] 的来源。也就是说,引用编号来自系统整理后的 evidence 顺序,而不是模型自己发明的一套来源列表。
第三,Writer prompt 明确要求模型使用 [number] 格式引用上下文中的来源。例如,如果某句话依据第 1 个搜索结果,就写成:
某个事实陈述[1]。
如果同一句话同时由多个来源支持,可以写成:
某个综合判断[1][2]。
这一步本质上仍然是 LLM 按 prompt 生成文本。系统没有在生成阶段逐句自动验证引用是否真的支撑该句,而是通过上下文编号和 prompt 约束,让 Writer 尽量把事实绑定到对应 evidence。
第四,前端拿到 Writer 流式输出的文本后,会扫描文本里的 [number] 标记。当前端看到 [1] 时,就去 source block 的来源数组里取 sources[0];看到 [2] 时,就取 sources[1]。如果这个 source 有 URL,前端就把纯文本 [1] 替换成一个可点击的 citation 链接。
可以把它抽象成:
Writer 输出:
  "这个模型发布了新的能力[1],并在多个评测中表现突出[2]。"

前端处理:
  [1] -> sources[0].metadata.url
  [2] -> sources[1].metadata.url

最终渲染:
  带可点击链接的引用角标
所以,Vane 的 citation 机制不是一个独立的“引用生成器”,而是一套跨阶段的编号协议:
Researcher 搜索结果
  -> 去重排序后的 source array
  -> Writer context 中的 <result index=N>
  -> Writer 按 prompt 输出 [N]
  -> 前端把 [N] 映射回 source[N-1].url
这里也解释了为什么 Widget 结果通常不会出现在引用标记里。Widget 的上下文会放进 widgets_result,Writer 可以使用它来回答,但系统明确告诉 Writer 不要把 Widget 当作 citation source。换句话说:
search_results:可以引用,因为它们有来源 URL 和 source 编号。widgets_result:可以使用,但不作为 citation。
这种设计的优点是简单、流式友好。Writer 可以边生成边输出 [1],前端可以在渲染时立即把它变成链接,不需要等整篇文章生成完再做复杂后处理。
它的局限也很明显:引用是否精确支撑每句话,主要依赖 Writer 遵守 prompt;系统只保证 [N] 能映射到第 N 个来源,并不自动做 claim-level citation verification。如果模型引用错编号,前端仍会忠实地把 [N] 链接到对应 source。
这一步的本质是 evidence-conditioned generation:
用户问题
+ 对话历史
+ 搜索证据
+ Widget 结构化结果
+ 写作指令
  -> LLM 生成答案
因此,Vane 的搜索 Agent 不是一个单 LLM 调用,而是:
LLM 分类
+ LLM 工具决策
+ 搜索引擎
+ embedding rerank
+ 可选 LLM 事实抽取
+ LLM 最终写作
这是一个多模型、多工具、多阶段 pipeline。
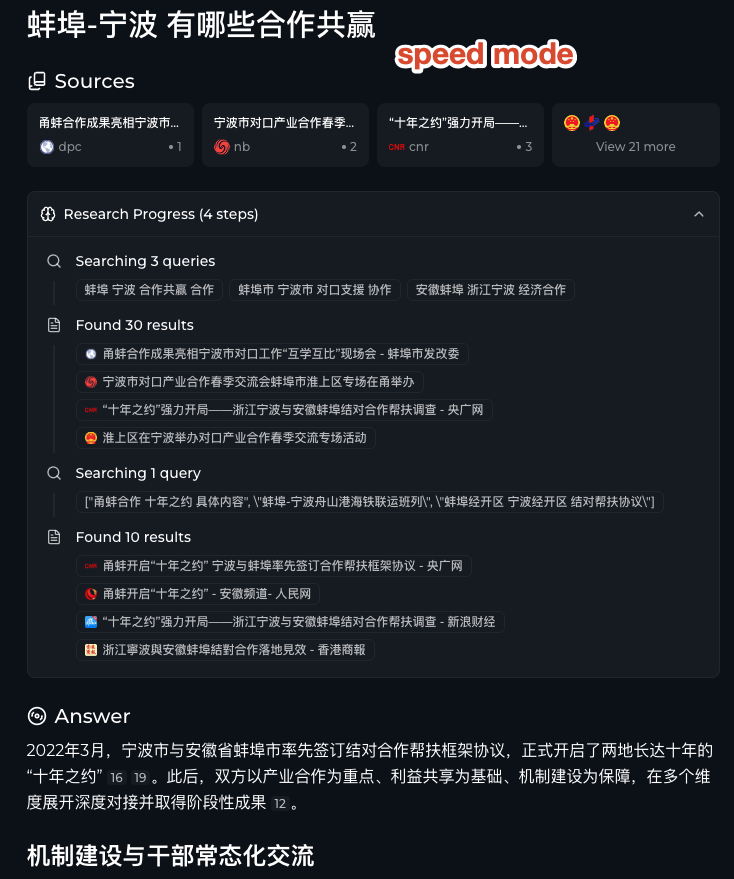
11. 状态控制与流式传输:为什么用户能看到中间过程
系统将整个回答过程拆成多个 block:
- research block:研究过程。
- reasoning substep:Balanced 的短计划。
- searching substep:正在搜索哪些 query。
- search_results substep:搜索结果。
- reading substep:阅读 URL 的结果。
- source block:最终可引用来源。
- widget block:天气/股票/计算结果。
- text block:最终回答文本。
后端维护一个 session,所有 block 都存在 session 中。每当 block 新增或更新,就向前端推送一个事件。
流式传输有两条线:
第一条是 Researcher 的工具调用流:
LLM streaming tool call delta
  -> 逐步解析工具参数
  -> 如果是 reasoning preamble,就实时更新 research block
第二条是 Writer 的文本生成流:
LLM streaming content token
  -> 累积到 text block
  -> 持续 patch 给前端
所以用户看到的不是一次性完成的回答,而是:
正在研究
  -> 正在搜索
  -> 搜索结果出现
  -> 研究完成
  -> 最终答案逐字流出
Balanced 模式比 Speed 多出的可见体验,主要就是 reasoning preamble。
12. Speed 与 Balanced 的本质区别
| 维度 | Speed | Balanced |
|---|---|---|
| 核心目标 | 快速给出够用答案 | 在速度和覆盖度之间平衡 |
| Researcher 最大轮数 | 2 | 6 |
| Reasoning 展示 | 无 | 有,使用 __reasoning_preamble |
| 查询策略 | 一次性打出最关键 query | 先广后窄,可多轮 reformulate query |
| web_search 调用倾向 | 通常一次 | 可多次 |
| 工具调用前计划 | 不要求 | 强制短计划 |
| 底层搜索执行 | SearXNG + embedding rerank + 去重 | 同 Speed |
| 适合问题 | 简单事实、快速查新、低延迟 | 多角度问题、需要少量对比或解释的问题 |
最关键的一句话:
Speed 与 Balanced 的搜索引擎和 rerank 算法基本相同,区别主要是 Agent 的行动策略不同。
Speed 是“少想、快查、快答”。
Balanced 是“先说明下一步、查一轮、看结果、再决定是否继续”。
13. 如果要复刻这个算法,可以怎么做
可以按以下模块复刻。
13.1 定义统一模型接口
需要一个 LLM 抽象:
generateObject(prompt, schema)
streamText(messages, tools?)
如果模型支持原生 tool calling,优先使用原生工具调用。如果不支持,才考虑 prompt JSON 模板 + parser 的降级方案。
还需要一个 embedding 抽象:
embedText(texts) -> vectors
13.2 实现 Classifier
用 LLM + JSON schema 输出:
skipSearch
personalSearch
academicSearch
discussionSearch
showWeatherWidget
showStockWidget
showCalculationWidget
standaloneFollowUp
这一步是系统路由器。
13.3 实现 WidgetExecutor
注册若干专用 widget:
- Weather
- Stock
- Calculation
每个 Widget 有:
shouldExecute(classification)
execute(input) -> widget result + llmContext
Widget 与 Researcher 并行执行。
13.4 实现 Researcher Agent
定义工具注册表:
web_search
academic_search
social_search
uploads_search
scrape_url
reasoning_preamble
done
每个工具包含:
name
schema
description
enabled(config)
execute(params, runtime)
Researcher loop:
maxIteration = speed ? 2 : balanced ? 6 : 25
history = [standalone question + recent conversation]
for i in range(maxIteration):
    tools = enabled tools
    prompt = researcher prompt(mode, i, maxIteration, tools)
    toolCalls = llm.streamText(messages=[prompt, history], tools=tools)
    if no toolCalls: break
    if last tool is done: break
    results = execute toolCalls
    append assistant toolCalls and tool results to history
return deduped findings
13.5 实现 web_search
for query in queries[:3]:
    results = search_engine(query)
    qVec = embed(query)
    for result in results:
        text = result.snippet or result.title
        rVec = embed(text)
        score = cosine(qVec, rVec)
        keep if score > threshold
merge all results
sort by score desc
deduplicate by result embedding similarity
return topK
13.6 实现 Writer
context = serialize(search_results, widgets_result)
answer = llm.streamText(system_writer_prompt + chat_history + user_query)
Writer 不再调用工具。
14. 算法评价
14.1 设计优点
第一,系统把“是否需要搜索”和“怎么搜索”分开了。Classifier 只负责路由,Researcher 才负责多轮信息收集。
第二,Widget 和 Researcher 并行,避免所有问题都走通用搜索路径。天气、股票、计算这类问题用结构化组件更稳定。
第三,Researcher 不是固定 pipeline,而是 LLM-controlled tool loop。它可以根据上一轮工具结果改写下一轮 query。
第四,Speed/Balanced 的差异被抽象成 Agent 策略,而不是复制两套搜索系统。这使得模式设计比较简洁。
第五,embedding rerank 是一个轻量但有效的搜索结果清洗层,尤其适合 Speed/Balanced 这种不抓全文的模式。
14.2 设计局限
第一,Speed 和 Balanced 底层检索完全共享,Balanced 的质量提升主要依赖 LLM 自己能否提出更好的后续 query。如果 LLM 没有很好利用多轮预算,Balanced 可能只是更慢而不明显更好。
第二,Speed/Balanced 的 web_search 主要基于搜索摘要,不默认阅读全文。这会降低答案深度,尤其当摘要不足或搜索结果标题党时。
第三,Researcher 的上下文控制比较粗粒度。它截断对话历史,但工具结果可能在多轮中持续膨胀。
第四,scrape_url 虽然是阅读工具,但 prompt 限制它不要主动调用。对于 Balanced 来说,如果希望更像真正 Research Agent,可能需要允许它在发现高价值来源后主动阅读。
第五,并行工具执行需要非常小心结果顺序和 tool call id 的对应关系。否则可能出现工具结果与工具调用消息错配的问题。
15. 总结
Vane 的 Agent 搜索系统可以概括为:
LLM Router
  -> Parallel Widgets
  -> Tool-using Researcher Agent
  -> Evidence Packager
  -> Streaming Writer
Speed 和 Balanced 是同一套系统上的两种研究策略:
Speed把研究压缩成低轮次、无显式 reasoning、一次性搜索优先的快速路径。Balanced引入短 reasoning、多轮搜索和 query 收敛,使搜索过程更可解释,也更有机会覆盖复杂问题。
如果要复刻这个算法,关键不是复制某个 API,而是复刻这几个抽象:
- LLM 结构化分类器。
- 可动态启用的工具注册表。
- 基于原生 tool calling 的 Researcher loop。
- 搜索引擎召回 + embedding rerank + 去重。
- Widget 与 Researcher 并行。
- Writer 使用 evidence context 生成最终回答。
- 用 block/patch 流式暴露中间过程。
这样,一个读者即使不看代码,也能理解 Vane 的 Agent 搜索算法是如何从“用户问一句话”一步步演化成“可解释、可引用、可流式输出的答案”的。